La mise en miroir (mirroring) dans Microsoft Fabric réplique en continu vos bases opérationnelles vers OneLake sous forme de tables Delta, sans pipeline ETL à écrire. Le résultat concret : SQL Server, Azure SQL, Oracle ou PostgreSQL deviennent interrogeables depuis Power BI, Spark ou n’importe quel moteur Fabric en quasi temps réel. Biworks recommande cette approche dès qu’un projet de reporting ou de data science exige des données fraîches sans multiplier les jobs de copie.
En bref:
- La mise en miroir dans Fabric crée une copie physique en fichiers Delta Parquet, ce qui augmente le coût de stockage, contrairement aux raccourcis qui ne dupliquent pas les données.
- La réplication nécessite une configuration rigoureuse des permissions, notamment sur la journalisation, et une passerelle fiable pour les bases on-premise, pour éviter les interruptions silencieuses.
- La stratégie idéale dépend du volume de lecture, avec la mise en miroir privilégiée pour des bases volumineuses en lecture analytique, et les raccourcis pour des lacs déjà en format Delta ou Parquet.
- La mise en miroir de bases Oracle ou PostgreSQL exige des changements de configuration spécifiques, comme LogMiner ou wal_level, avec des tests préalables pour éviter saturations ou incohérences.
- Surveiller la réplication en production se fait principalement via le moniteur Fabric, en vérifiant permissions, connectivité, et schémas, avec un plan de rollback bien documenté.
Biworks
Déployez vos solutions Fabric avec méthode
Biworks vous accompagne dans vos projets BI, l’intégration et la sécurisation des solutions cloud Microsoft.
Table des matières
- Pourquoi utiliser la mise en miroir dans Fabric : bénéfices et limites techniques
- Ce que la mise en miroir crée réellement dans OneLake
- Les trois types de mise en miroir et comment choisir
- Configurer la mise en miroir depuis SQL Server et Azure SQL
- Mise en miroir depuis Oracle et PostgreSQL : ce qui change
- La mise en miroir ouverte pour les applications qui écrivent leur propre CDC
- Interroger et partager les données mises en miroir
- Combien coûte réellement la mise en miroir face aux raccourcis
- Bonnes pratiques d’ingénierie des données avec des bases mises en miroir
- Exploiter les miroirs pour la data science et l’entraînement de modèles
- Surveiller et dépanner un miroir en production
- Ce que Biworks retient après avoir déployé la mise en miroir en production
- Un accompagnement Biworks pour déployer la mise en miroir sans mauvaise surprise
- Sources
- Questions fréquentes
Pourquoi utiliser la mise en miroir dans Fabric : bénéfices et limites techniques
L’intérêt majeur tient au format de sortie : les données arrivent directement en Delta Parquet, exploitables sans transformation préalable par un notebook Spark, un modèle Power BI ou un pipeline de data science.
Cette simplicité a un prix. Les défenseurs du « zero ETL » oublient souvent que dupliquer physiquement une base de plusieurs téraoctets consomme du stockage OneLake, génère des coûts d’entrées-sorties et impose une charge opérationnelle réelle, entre quotas à surveiller et nettoyage régulier des fichiers Delta.
Face aux raccourcis (shortcuts), qui pointent vers des données sans les copier, la mise en miroir tranche nettement :
- Raccourcis : zéro duplication, latence dépendante de la source externe, gouvernance héritée telle quelle.
- Mise en miroir : copie physique en Delta, latence maîtrisée par Fabric, mais sécurité à reconfigurer manuellement.
- Cas d’usage typique : mise en miroir pour des bases transactionnelles à forte volumétrie de lecture analytique, raccourcis pour des lacs déjà en Delta ou Parquet.
Le choix dépend donc moins de la technique que du compromis coût de stockage contre simplicité d’exploitation.
Ce que la mise en miroir crée réellement dans OneLake
Quand vous activez la mise en miroir, Fabric ne se contente pas de copier des lignes. Il construit un objet base de données miroir dans votre espace de travail, qui matérialise chaque table source en fichiers Delta Parquet stockés dans OneLake, avec un point d’accès SQL endpoint généré automatiquement pour les requêtes T-SQL classiques.
Trois flux d’usage découlent de cette architecture :
- Des notebooks Spark ou Python lisent directement les tables Delta pour du traitement en masse ou de la préparation de features.
- Le SQL endpoint sert les outils habitués au T-SQL, y compris les cabinets qui migrent des rapports SSRS existants.
- Power BI se connecte en mode Direct Lake, sans import ni requête DirectQuery classique, ce qui élimine la latence de rafraîchissement.
Cette matérialisation impacte aussi le catalogue Fabric : chaque table mise en miroir apparaît comme un objet natif, gouvernable via les mêmes règles de sensibilité que le reste du lakehouse. Un data engineer doit anticiper cette visibilité accrue dès la phase de conception, sous peine de voir des tables sensibles exposées sans contrôle adapté.
Les trois types de mise en miroir et comment choisir
Fabric propose trois types de mise en miroir, chacun répondant à un objectif distinct.
- Mise en miroir de bases de données : copie complète du contenu (SQL Server, Azure SQL, Oracle, PostgreSQL) en tables Delta. À privilégier quand l’analytique exige l’accès aux données brutes, ligne par ligne.
- Mise en miroir de métadonnées : réplique la structure et les références sans dupliquer les volumes lourds, une approche pertinente pour synchroniser un catalogue externe comme Unity Catalog sans payer le coût de stockage d’une copie intégrale.
- Mise en miroir ouverte (open mirroring) : permet à une application tierce d’écrire directement des changements via API, sans connecteur natif Fabric.
Le critère de choix tient en une question : avez-vous besoin des données elles-mêmes ou seulement de leur structure pour orchestrer un partage inter-locataires ? La métadonnées gagne en légèreté et en rapidité de mise en place, la base de données complète gagne en autonomie analytique. L’ouverte, elle, cible les équipes qui contrôlent leur code applicatif et veulent injecter du changement de données (CDC) sans attendre un connecteur officiel.
Configurer la mise en miroir depuis SQL Server et Azure SQL
La procédure diverge légèrement entre les deux sources, mais les fondations restent identiques : identités managées, permissions minimales, et connectivité réseau fiable.
- Vérifiez les prérequis d’identité. Fabric s’appuie sur une identité managée pour authentifier la connexion. Créez un utilisateur dédié côté SQL, généralement nommé
fabric_login, puis accordez-lui les droits nécessaires à la capture des changements. - Installez une passerelle si la source est on-premise. Une passerelle de données locale ou VNet devient obligatoire dès que SQL Server ne réside pas dans Azure. Cette passerelle introduit ses propres contraintes : ouverture de ports sortants, configuration du pare-feu, et idéalement une architecture en haute disponibilité pour éviter un point de rupture unique.
- Pour SQL Server 2025, anticipez Azure Arc. Cette version impose l’inscription du serveur via Azure Arc pour activer la mise en miroir, une étape souvent sous-estimée dans les plannings de migration.
- Créez la connexion dans le portail Fabric. Renseignez le serveur, la base cible et les informations d’authentification de l’utilisateur
fabric_login. - Créez la base miroir en sélectionnant les objets à répliquer : tables individuelles ou ensemble complet.
- Surveillez la réplication via le moniteur natif, qui affiche l’état par table et signale les échecs de synchronisation.
Conseil de pro : évitez l’option « répliquer toutes les tables » sur une première mise en production. Commencez par un périmètre restreint de trois à cinq tables critiques, validez la cohérence des données, puis élargissez progressivement. Cette discipline évite de polluer OneLake avec des tables jamais consultées.
Les pièges les plus fréquents concernent les permissions insuffisantes sur le journal de transactions et l’oubli de reconfigurer les règles de sécurité au niveau ligne (RLS) ou colonne (OLS), qui ne sont jamais répliquées automatiquement depuis la source.
Mise en miroir depuis Oracle et PostgreSQL : ce qui change
Oracle et PostgreSQL imposent des contraintes techniques propres, plus exigeantes que celles de l’écosystème SQL Server.
- Oracle nécessite l’activation de LogMiner pour capturer les changements, ainsi qu’une passerelle de données locale et une version minimale du On-premises Data Gateway (OPDG). Vérifiez la version d’Oracle supportée avant tout projet : les versions trop anciennes ne proposent pas l’interface de capture attendue par Fabric.
- PostgreSQL exige de basculer
wal_levelsurlogical, d’installer l’extension azure_cdc, et souvent d’augmentermax_worker_processespour absorber la charge de réplication sans dégrader les performances transactionnelles. Un rôle dédié avec permissions de réplication doit posséder les objets concernés, faute de quoi la capture échoue silencieusement.
Conseil de pro : testez toujours ces changements de configuration (wal_level, LogMiner) sur un environnement de préproduction avant de les appliquer en production. Le passage en mode logique de PostgreSQL, par exemple, augmente la rétention des journaux WAL et peut saturer un disque mal dimensionné si personne n’a anticipé l’espace supplémentaire requis.
Sur les deux moteurs, la sécurité mérite une attention particulière : les comptes de service créés pour la mise en miroir doivent recevoir le strict minimum de droits, jamais un rôle administrateur par facilité.
La mise en miroir ouverte pour les applications qui écrivent leur propre CDC
L’open mirroring cible un profil précis : les équipes qui développent des applications capables d’émettre elles-mêmes leurs changements de données via API, sans dépendre d’un connecteur Fabric natif. Un système de facturation interne ou un moteur IoT maison peut ainsi publier ses événements directement dans OneLake.
Ce mode impose des contraintes que les data engineers doivent connaître avant de s’engager :
- Les fichiers écrits doivent respecter le format Delta Lake attendu par Fabric, ce qui suppose une couche applicative capable de générer des journaux de transactions Delta valides.
- L’architecture typique repose sur un service qui capture les changements côté source, les convertit en format Delta, puis les dépose dans le dossier cible via l’API dédiée.
- La compatibilité reste stricte : toute déviation du schéma Delta attendu casse la synchronisation sans toujours produire une erreur explicite côté application émettrice.
Le point de vigilance principal concerne les tests de schéma. Une évolution de structure côté application, ajout de colonne ou changement de type, doit être validée avant déploiement, sinon le miroir accumule des incohérences invisibles jusqu’à la première requête analytique en échec.
Interroger et partager les données mises en miroir
Une fois les tables Delta disponibles dans OneLake, l’exploitation quotidienne repose sur trois mécanismes complémentaires.
- Les requêtes inter-bases permettent de joindre une table miroir SQL Server avec une table Oracle miroir dans la même requête T-SQL, via le SQL endpoint partagé de l’espace de travail.
- Le partage inter-locataires s’appuie souvent sur des raccourcis pointant vers les tables miroir, ce qui synchronise les métadonnées sans dupliquer une nouvelle fois le stockage.
- Direct Lake dans Power BI lit directement les fichiers Delta sans import ni requête DirectQuery, ce qui réduit fortement la latence de rafraîchissement des rapports, à condition de surveiller la fragmentation des fichiers Parquet.
Pour les notebooks, la bonne pratique consiste à lire les tables miroir en lecture seule et à écrire les résultats transformés dans un lakehouse séparé, jamais dans la base miroir elle-même, qui reste un espace géré exclusivement par Fabric.
Combien coûte réellement la mise en miroir face aux raccourcis
Le stockage OneLake se facture selon le SKU Fabric souscrit, et chaque table mise en miroir occupe un espace réel puisqu’elle duplique physiquement les données sources. Une base de dix gigaoctets mise en miroir consomme dix gigaoctets supplémentaires dans OneLake, contrairement à un raccourci qui ne facture qu’un pointeur.
Point de repère économique : l’avantage « zero ETL » de la mise en miroir masque un coût de stockage et d’entrée-sortie bien réel une fois la volumétrie en production, ce qui justifie de planifier des quotas et une stratégie de nettoyage dès la conception plutôt qu’après le premier dépassement de capacité.
Trois indicateurs méritent un suivi régulier : le volume de stockage OneLake consommé par table miroir, la fréquence des opérations d’entrée-sortie liées à la réplication continue, et l’écart de latence entre la source et la dernière synchronisation visible dans le moniteur Fabric.
Bonnes pratiques d’ingénierie des données avec des bases mises en miroir
Un pipeline robuste autour de la mise en miroir suit quelques règles simples mais rarement respectées en pratique.
- Nommez les objets miroir de façon cohérente avec le reste du lakehouse, en évitant les noms hérités tels quels de la base source qui perdent leur sens une fois isolés dans OneLake.
- Filtrez les objets à répliquer dès la configuration plutôt que de subir l’option « toutes les tables », qui charge souvent des objets techniques ou obsolètes jamais consultés en analytique.
- Adoptez une architecture medallion (bronze, silver, gold) où les tables miroir jouent le rôle de couche bronze brute, jamais transformée directement, avant qu’un job de nettoyage ne produise la couche silver.
- Intégrez les migrations de schéma dans un processus CI/CD, avec des tests automatisés qui valident la structure des tables miroir avant chaque déploiement en production.
Conseil de pro : documentez systématiquement quelles règles RLS et OLS existaient côté source avant la mise en miroir. Cette liste devient votre feuille de route pour reconstruire la sécurité côté Fabric, une étape que beaucoup d’équipes découvrent trop tard, une fois les données déjà exposées sans filtre.
Exploiter les miroirs pour la data science et l’entraînement de modèles
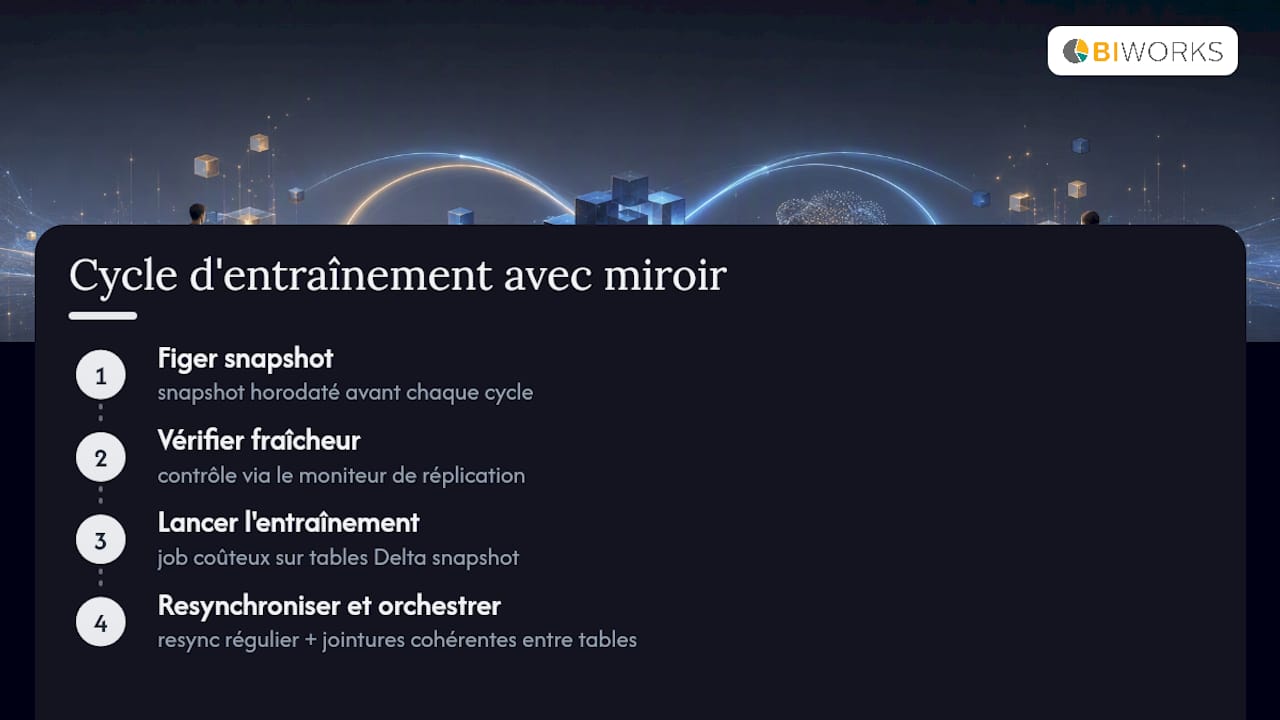
Les tables Delta issues de la mise en miroir constituent une base solide pour l’entraînement de modèles, à condition de composer avec deux réalités techniques. La première concerne la latence : un modèle entraîné sur un instantané peut légèrement diverger des données les plus récentes si le pipeline d’entraînement ne se resynchronise pas régulièrement avec l’état courant du miroir.
La seconde touche la cohérence transactionnelle. Delta Lake garantit des lectures cohérentes grâce à son mécanisme de versionnement, mais un feature store construit sur plusieurs tables miroir doit orchestrer ses jointures avec soin pour éviter de croiser des versions temporellement incohérentes entre deux sources différentes.
La recommandation pratique : figez un instantané (snapshot) horodaté avant chaque cycle d’entraînement, et validez la fraîcheur des données via le moniteur de réplication avant de lancer un job coûteux en calcul.
Surveiller et dépanner un miroir en production
Le moniteur natif de Fabric affiche l’état de réplication table par table, avec les journaux d’erreurs associés à chaque échec de synchronisation.
- Consultez d’abord l’état global de la base miroir dans le portail : un statut « en erreur » pointe généralement vers un problème de permissions ou de connectivité réseau.
- Vérifiez les permissions du compte de service utilisé pour la capture des changements, en particulier après une rotation de mot de passe ou une modification de rôle côté base source.
- Testez la passerelle de données si la source est on-premise : une passerelle hors ligne interrompt silencieusement la réplication sans toujours générer d’alerte immédiate.
- Examinez les journaux internes de réplication pour identifier une erreur de schéma, souvent liée à une évolution de structure non anticipée côté source.
- Prévoyez un plan de rollback documenté, avec validation post-déploiement systématique après toute modification de configuration réseau ou de permissions.
Ce que Biworks retient après avoir déployé la mise en miroir en production
La mise en miroir séduit par sa promesse de simplicité, mais elle déplace la complexité plutôt que de la supprimer : elle passe du code ETL vers la gouvernance et le dimensionnement du stockage. Il est recommandé de démarrer tout projet par un pilote à périmètre restreint, avec un audit préalable des permissions réseau et des identités managées.
Trois points à vérifier avant tout déploiement : la disponibilité d’une passerelle stable, la reconfiguration explicite des règles RLS/OLS, et un scope initial limité à quelques tables critiques plutôt qu’une réplication intégrale.
— François
Un accompagnement Biworks pour déployer la mise en miroir sans mauvaise surprise
Configurer un miroir SQL Server ou Oracle en autonomie prend souvent plusieurs semaines d’essais quand les permissions ou la passerelle ne sont pas correctement anticipées dès le départ. Des accompagnements sont proposés aux équipes IT sur l’audit technique préalable, l’intégration proprement dite et l’écriture des scripts d’automatisation nécessaires pour fiabiliser la réplication en production.
Pour les équipes qui souhaitent monter en compétence directement plutôt que de tout externaliser, Une formation certifiante Power BI et Fabric éligible CPF, préparant à la certification PL-300 sur trois jours, est également disponible. Si votre projet implique une architecture Fabric plus large, Une page dédiée au conseil en business intelligence détaille diverses prestations d’intégration.
Vous pouvez décrire votre besoin via un formulaire de projet business intelligence pour obtenir un premier retour technique sur votre architecture de mise en miroir.
Sources
- Tutoriel : Configurer la mise en miroir de bases de données Oracle dans Microsoft Fabric
- Tutoriel : Configurer des bases de données mises en miroir Microsoft Fabric à partir d’Azure Database pour PostgreSQL
- OneLake overview
Questions fréquentes
Qu’est-ce que la mise en miroir dans Microsoft Fabric ?
C’est une réplication continue et en lecture seule d’une base opérationnelle vers OneLake, sous forme de tables Delta Parquet directement exploitables par les moteurs Fabric, sans écrire de pipeline ETL.
Quelle différence entre raccourcis et mise en miroir dans Fabric ?
Un raccourci pointe vers des données existantes sans les dupliquer, tandis que la mise en miroir copie physiquement les données en continu dans OneLake, ce qui consomme du stockage mais offre une latence maîtrisée par Fabric.
Que signifie concrètement la mise en miroir de données ?
Cela désigne la synchronisation automatique et quasi continue du contenu d’une base source vers une base cible, ici OneLake, de façon à ce que toute modification côté source se reflète rapidement côté analytique.
Comment configurer la mise en miroir Oracle dans Microsoft Fabric ?
Il faut activer LogMiner côté Oracle, installer une passerelle de données locale avec la version minimale d’OPDG requise, puis créer la connexion et la base miroir depuis le portail Fabric avant de surveiller l’état de réplication.