L’ETL (extraction, transformation, chargement) est le processus qui récupère des données brutes issues de sources multiples, les nettoie et les restructure selon des règles métier, puis les dépose dans un entrepôt de données prêt pour l’analyse. Cette mécanique reste le socle silencieux de tout projet de reporting fiable : sans elle, vos tableaux de bord affichent des chiffres dont la fiabilité peut être douteuse en comité de direction. À côté, une variante nommée ELT inverse l’ordre des opérations et gagne du terrain avec les entrepôts cloud.
En bref:
- L’ETL extrait, transforme et charge les données, ce qui peut limiter la gouvernance des données brutes dans les environnements réglementés.
- Le choix entre ETL et ELT dépend du volume de données et des exigences de conformité, ELT étant privilégié pour explorer des données massives dans le cloud.
- La performance et la sécurité du pipeline ETL reposent sur une architecture bien conçue, avec une surveillance constante et une gestion rigoureuse des accès et du chiffrement.
- Les outils ETL doivent offrir connecteurs multiples, scalabilité, observabilité et orchestration intégrée pour garantir une fiabilité optimale en production.
- La résilience d’un pipeline ETL passe par la modularité, la gestion automatique des échecs, une documentation précise et une traçabilité robuste.
Table des matières
- Comment fonctionne l’ETL : les trois étapes en détail
- ETL ou ELT : quel modèle choisir selon votre contexte ?
- Quels critères retenir pour choisir un outil ETL ou ELT ?
- Dans quels cas métier l’ETL fait vraiment la différence
- Performances, limites et coûts réels d’un pipeline ETL
- Orchestrer un pipeline ETL fiable : les pratiques qui comptent
- Comment sécuriser efficacement un pipeline ETL
- Que faire quand un pipeline ETL échoue en production ?
- Comment garantir la qualité des données pendant l’ETL
- Automatiser et surveiller ses pipelines ETL au quotidien
- Perspective Biworks : ancrer l’ETL dans vos projets Power BI et Fabric
- Structurer vos flux ETL avec un accompagnement expert
- Sources
- Questions fréquentes
Comment fonctionne l’ETL : les trois étapes en détail
Un pipeline ETL n’est jamais un bloc monolithique. C’est une chaîne de trois opérations distinctes, chacune avec ses propres pièges et ses propres arbitrages techniques.
L’extraction consiste à aller chercher la donnée là où elle vit : bases relationnelles (SQL Server, PostgreSQL, Oracle), API SaaS, fichiers plats (CSV, Excel, FEC comptable), ou flux temps réel issus de capteurs. Trois stratégies coexistent. L’extraction complète (full) rejoue toute la source à chaque exécution, simple mais coûteuse en volume. L’extraction incrémentale ne récupère que les enregistrements modifiés depuis le dernier passage, ce qui suppose une colonne de type date de mise à jour fiable. Le CDC (Change Data Capture) va plus loin : il capte chaque insertion, modification ou suppression directement dans les journaux de transaction de la base source, sans surcharger le système opérationnel.
La transformation est l’étape où la valeur se construit vraiment. On y trouve le nettoyage des doublons et des valeurs manquantes, l’enrichissement par croisement avec des référentiels externes, l’agrégation pour produire des indicateurs consolidés, et la validation métier qui rejette ou signale les enregistrements incohérents. Un principe trop souvent négligé : l’idempotence. Une transformation idempotente peut être rejouée plusieurs fois sur le même lot sans dupliquer ni corrompre le résultat, ce qui devient vital le jour où un batch échoue à mi-chemin.
Le chargement dépose enfin les données transformées dans leur destination finale, qu’il s’agisse d’un entrepôt de données classique, d’un data mart dédié à un métier, ou d’un lakehouse combinant stockage brut et structuré, comme le permet l’architecture Microsoft Fabric.
Concrètement, un flux typique en comptabilité ressemble à ceci :
- Extraction du grand livre depuis l’ERP au format FEC ;
- Transformation : réconciliation des comptes, calcul des soldes, détection des écritures atypiques ;
- Chargement dans un modèle en étoile prêt pour Power BI, avec table de faits et dimensions temps, compte, tiers.
Chaque étape produit un schéma de sortie différent du schéma d’entrée, et c’est précisément cette réorganisation qui rend l’analyse possible ensuite.
ETL ou ELT : quel modèle choisir selon votre contexte ?
La différence tient en une phrase : l’ETL transforme les données avant de les charger, l’ELT les charge brutes et les transforme ensuite directement dans l’entrepôt cible. Ce choix n’est pas cosmétique, il détermine où se joue la gouvernance, qui a accès aux données brutes, et quelle puissance de calcul vous mobilisez.
| Critère | ETL | ELT |
|---|---|---|
| Ordre des opérations | Transformation avant chargement | Chargement avant transformation |
| Lieu de transformation | Serveur ETL dédié | Entrepôt cloud cible |
| Gouvernance des données brutes | Limitée (données filtrées en amont) | Étendue (données brutes conservées) |
| Performance sur gros volumes | Peut ralentir sur des volumes massifs | Tire parti du calcul distribué cloud |
| Cas d’usage type | Environnements régulés, conformité stricte | Exploration analytique, data science |
Les environnements réglementés (banque, assurance, secteur public) privilégient encore l’ETL classique, car transformer avant de charger limite l’exposition de données sensibles non filtrées. À l’inverse, une équipe data science qui veut explorer des données brutes sans savoir à l’avance quelles transformations seront utiles gagnera à charger d’abord et transformer ensuite, en s’appuyant sur la puissance de calcul d’un entrepôt cloud moderne.
Dans la pratique, beaucoup d’organisations ne choisissent plus l’un contre l’autre. Les architectures récentes combinent les deux : ETL pour les flux sensibles ou réglementés qui exigent une traçabilité fine, ELT pour les ingestions massives et les usages exploratoires. Une règle empirique utile : si votre volume dépasse largement les capacités de votre serveur de transformation, ou si vos analystes ont besoin d’accéder aux données avant qu’elles ne soient filtrées, penchez vers l’ELT. Si la conformité impose de ne jamais stocker de donnée brute non contrôlée, restez en ETL.
Quels critères retenir pour choisir un outil ETL ou ELT ?
Le choix d’un outil se joue rarement sur la liste de fonctionnalités affichée sur une page marketing. Il se joue sur des critères opérationnels que l’on découvre souvent trop tard, une fois le pipeline en production.
- Les connecteurs disponibles : votre outil couvre-t-il nativement vos sources (ERP, CRM, bases SQL, API) sans développement de connecteur maison à chaque mise à jour ?
- La scalabilité : le moteur de transformation tient-il la charge quand votre volume de données double en un an, sans réécriture complète du pipeline ?
- L’observabilité : pouvez-vous suivre en temps réel la durée d’exécution, le taux d’erreur et la fraîcheur des données sans consulter des journaux bruts ?
- L’orchestration : l’outil gère-t-il nativement les dépendances entre tâches, les tentatives automatiques et la planification, ou faut-il un orchestrateur externe ?
- La sécurité : chiffrement au repos et en transit, gestion fine des accès, traçabilité des traitements sont-ils intégrés ou ajoutés après coup ?
- Le coût total : licence, infrastructure sous-jacente, temps d’ingénieur nécessaire à la maintenance. Un outil « gratuit » qui demande deux jours-homme par semaine n’est jamais gratuit.
Le choix entre cloud et infrastructure sur site pèse aussi lourd sur ces critères. Un hébergement cloud, chez des fournisseurs comme OVHcloud ou les plateformes Microsoft Azure, mutualise la puissance de calcul et simplifie la scalabilité, mais déplace la question de la sécurité vers la configuration des accès et le chiffrement des flux. Le on-premise garde un contrôle total sur la localisation des données, au prix d’une maintenance interne plus lourde.
Trois grandes familles d’outils se distinguent aujourd’hui : les plateformes managées qui prennent en charge l’essentiel de l’infrastructure, les frameworks open source qui offrent plus de contrôle mais demandent une équipe technique solide, et les orchestrateurs qui coordonnent des tâches ETL déjà existantes sans les exécuter eux-mêmes.
Conseil de pro : avant tout appel d’offres technique, faites tourner un pilote sur un mois de données réelles, pas un jeu de test allégé. C’est souvent là que les vrais goulots d’étranglement et les connecteurs manquants apparaissent, bien avant la signature du contrat.
Dans quels cas métier l’ETL fait vraiment la différence
Certains contextes rendent l’ETL non pas utile, mais indispensable. En voici les plus fréquents.
- Reporting financier consolidé : rapprocher des données issues de plusieurs filiales, devises et systèmes comptables pour produire un bilan unique et vérifiable.
- Réconciliation ERP/CRM : croiser les commandes clients d’un CRM avec la facturation d’un ERP pour détecter les écarts avant qu’ils ne deviennent des litiges.
- Secteurs régulés : dans la banque ou la santé, chaque transformation doit être traçable, ce qui impose un pipeline ETL documenté plutôt qu’un chargement brut suivi d’ajustements ad hoc.
- Ingestion IoT et capteurs industriels : les contraintes de bande passante en périphérie de réseau (edge) obligent souvent à filtrer et agréger la donnée avant même son extraction complète, un cas où l’ETL classique reste plus pertinent que l’ELT.
Un cabinet d’expertise comptable qui centralise les fichiers FEC de vingt clients différents illustre bien l’enjeu : chaque fichier a son propre format d’export, ses propres codes de comptes, ses propres anomalies de saisie. Sans étape de transformation rigoureuse en amont, impossible de produire un audit comparatif fiable. C’est exactement le type de scénario où l’ETL, avec ses règles de validation métier intégrées, surpasse une simple copie de données brutes vers un tableau croisé dynamique.
Performances, limites et coûts réels d’un pipeline ETL
Un pipeline ETL mal conçu tombe presque toujours sur les mêmes obstacles : un moteur de transformation saturé par des volumes qu’il n’a pas été dimensionné pour absorber, des opérations d’entrée-sortie qui ralentissent tout le batch, ou des verrous d’écriture qui bloquent la table cible pendant la mise à jour.
Côté coûts, l’écart entre on-premise et cloud se joue moins sur la licence que sur l’exploitation : un serveur sur site immobilise du capital et du personnel dédié, tandis qu’un pipeline cloud facture à l’usage mais peut dériver vite si personne ne surveille la consommation de calcul.
- Durée moyenne d’exécution d’un batch, à comparer d’une semaine à l’autre pour détecter une dégradation ;
- Latence entre la disponibilité de la donnée source et son apparition dans l’entrepôt ;
- Taux d’erreur ou de rejet par lot, révélateur d’un problème de qualité amont ;
- Volume de retraitements manuels, signe d’une dette technique qui s’accumule.
La parallélisation des traitements autour de partitions logiques comme la date ou le client reste l’un des leviers les plus efficaces pour absorber la croissance des volumes sans réécrire tout le pipeline.
Orchestrer un pipeline ETL fiable : les pratiques qui comptent
Un pipeline qui fonctionne une fois en test ne garantit rien en production. Ce qui distingue un pipeline robuste d’un pipeline fragile, c’est sa capacité à survivre à un échec partiel sans intervention manuelle.
- Gérer les dépendances et les tentatives automatiques : chaque tâche doit savoir de quelle tâche précédente elle dépend, et pouvoir se relancer seule en cas d’échec transitoire, sans dupliquer les données déjà traitées.
- Surveiller activement : journaux détaillés, métriques de durée et de volume, seuils d’alerte définis à l’avance. Un pipeline silencieux qui échoue sans prévenir personne est le pire des scénarios.
- Cataloguer les métadonnées : documenter l’origine, la structure et les transformations appliquées à chaque flux évite que la zone de données brutes ne devienne un marécage de données impossible à exploiter.
- Concevoir de manière modulaire : des tâches courtes, testables isolément, valent toujours mieux qu’un script monolithique de trois mille lignes que seul son auteur comprend.
L’orchestration joue ici un rôle décisif pour la résilience globale : sans mécanisme de reprise (retry) et de rejeu (backfill) bien pensé, chaque incident se transforme en intervention d’urgence.
Conseil de pro : documentez systématiquement le comportement attendu en cas d’échec partiel d’un batch, avant même de l’écrire. C’est la question la plus souvent oubliée en phase de conception, et la plus coûteuse à corriger après coup.
Comment sécuriser efficacement un pipeline ETL
La sécurité d’un pipeline ETL se joue à trois niveaux, et négliger l’un d’eux expose toute la chaîne. D’abord, le chiffrement : les données doivent être protégées à la fois pendant leur transit entre systèmes et une fois stockées, qu’il s’agisse de la zone brute ou de l’entrepôt final. Un flux non chiffré entre votre ERP et votre plateforme cloud reste une faille classique, souvent découverte trop tard.
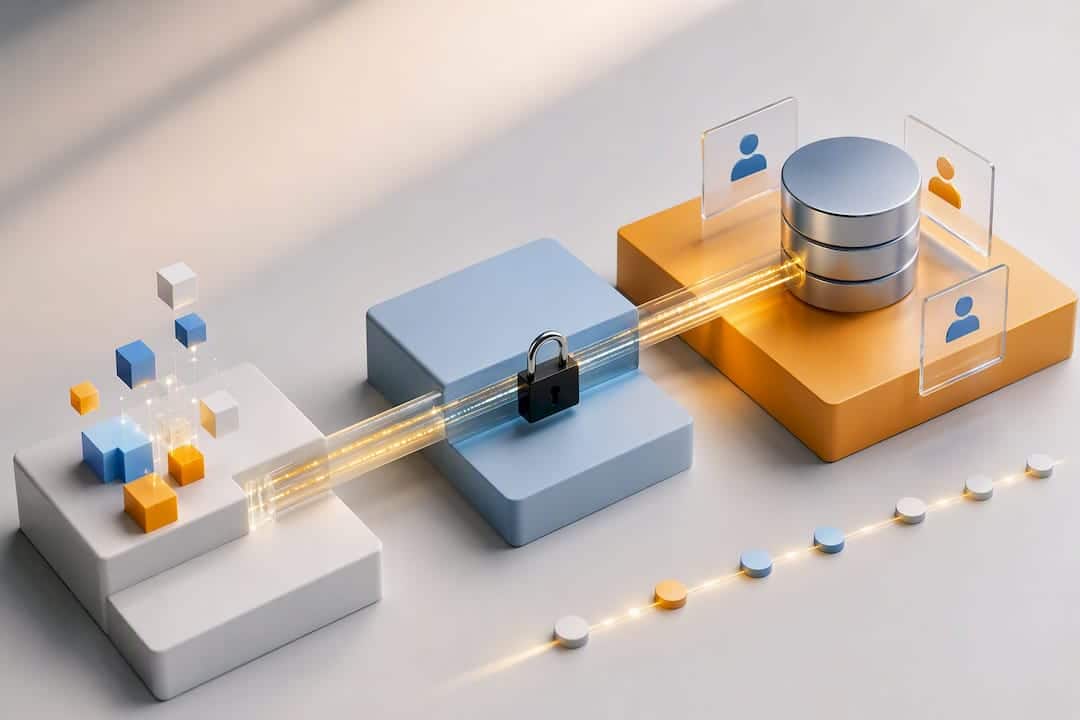
Ensuite vient la gestion des accès. Toutes les personnes qui interviennent sur un pipeline n’ont pas besoin des mêmes droits : un développeur qui construit les transformations n’a pas forcément besoin d’accéder aux données de production, et un analyste qui consulte les rapports finaux n’a aucune raison de voir les flux bruts non filtrés. Le principe du moindre privilège s’applique ici aussi strictement qu’ailleurs dans le système d’information.
Enfin, la traçabilité des traitements. Savoir qui a modifié quelle règle de transformation, à quelle date, et pourquoi, devient indispensable dès qu’un audit ou un contrôle réglementaire s’annonce. Dans les secteurs soumis à des obligations strictes, cette traçabilité conditionne souvent le choix même entre ETL et ELT : transformer avant de charger permet de contrôler précisément ce qui entre dans l’entrepôt, plutôt que de devoir justifier après coup pourquoi une donnée brute sensible s’y trouve.
Que faire quand un pipeline ETL échoue en production ?
Un pipeline qui ne tombe jamais en panne n’existe pas. La vraie question n’est donc pas comment éviter l’échec, mais comment le pipeline se comporte quand il survient.
La première ligne de défense reste la conception idempotente évoquée plus haut : si une tâche peut être rejouée sans dupliquer ni corrompre les données déjà chargées, un échec partiel devient une simple relance plutôt qu’une crise. La deuxième ligne concerne le découpage en petites unités de travail. Un batch unique qui traite un mois entier de données en une seule transaction échoue en bloc si un seul enregistrement pose problème ; un batch découpé par jour ou par lot permet d’isoler l’incident et de ne rejouer que la portion concernée.
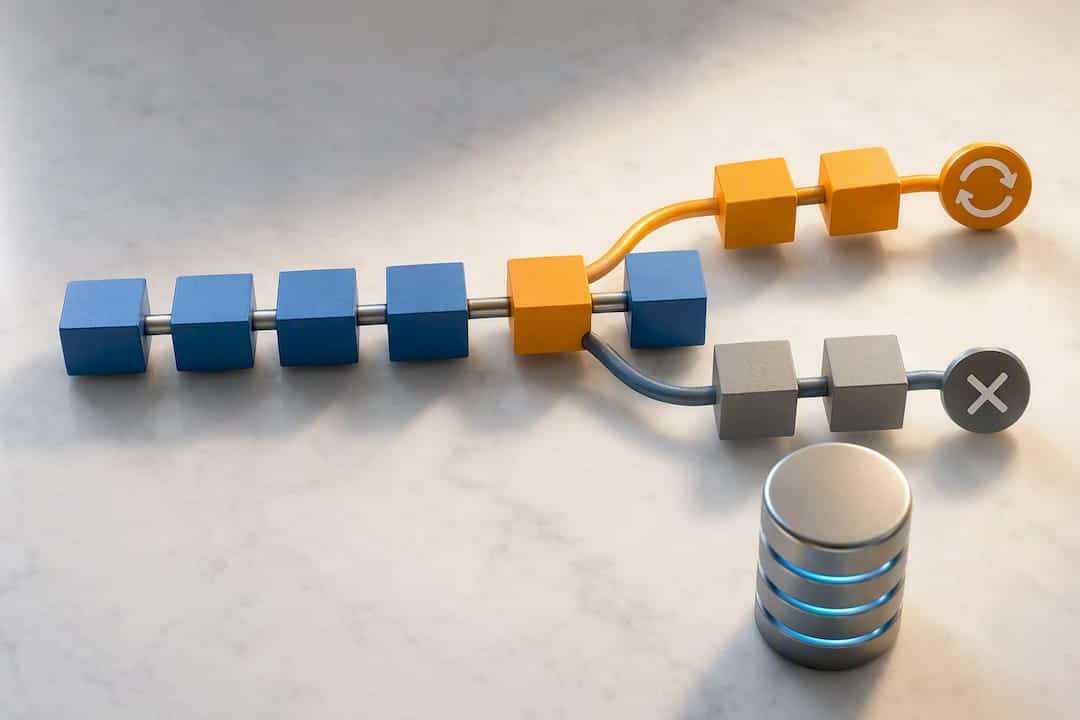
Le mécanisme de reprise doit aussi distinguer les erreurs transitoires, comme une coupure réseau momentanée qui se résout avec une nouvelle tentative automatique, des erreurs structurelles, comme un changement de format dans la source qui nécessite une intervention humaine. Confondre les deux mène soit à des relances infinies inutiles, soit à des alertes ignorées parce que trop fréquentes.
Enfin, conserver un journal détaillé de chaque exécution, avec l’état précis au moment de l’échec, permet de rejouer (backfill) uniquement les données manquantes plutôt que de tout recharger depuis le début, ce qui économise un temps de traitement précieux sur de gros volumes.
Comment garantir la qualité des données pendant l’ETL
La qualité des données ne se rattrape pas en aval, elle se construit pendant la transformation. Un tableau de bord Power BI parfaitement conçu reste inutile si les chiffres qui l’alimentent contiennent des doublons ou des valeurs incohérentes.
La validation métier intervient dès l’étape de transformation : vérifier qu’un montant de facture n’est pas négatif par erreur, qu’une date de transaction se situe dans une plage plausible, ou qu’un identifiant client existe bien dans le référentiel. Ces règles, une fois définies, doivent rejeter ou signaler automatiquement les enregistrements suspects plutôt que de les laisser polluer l’entrepôt cible.
Le nettoyage couvre ensuite la déduplication, la normalisation des formats (dates, devises, unités) et la gestion des valeurs manquantes, qu’il faut parfois exclure, parfois compléter par une valeur par défaut documentée. La gouvernance des flux de données qui encadre ces règles évite qu’elles ne divergent d’une équipe à l’autre au fil du temps.
Un point souvent sous-estimé : la qualité des données n’est pas un contrôle ponctuel réalisé au lancement du projet, mais un processus continu. Les sources changent, les formats évoluent, de nouveaux cas limites apparaissent. Prévoir des contrôles automatiques réguliers, plutôt qu’une validation manuelle en cas de doute, reste la seule approche qui tient dans le temps.
Automatiser et surveiller ses pipelines ETL au quotidien
L’automatisation d’un pipeline ETL ne se limite pas à programmer une exécution nocturne. Elle couvre la planification des tâches, la gestion automatique des dépendances entre elles et la capacité du système à s’ajuster sans intervention humaine face aux variations normales de volume.
Le monitoring, lui, doit répondre à une question simple à tout moment : le pipeline fonctionne-t-il correctement, et si non, pourquoi ? Cela suppose de suivre des indicateurs concrets, comme la durée d’exécution comparée aux jours précédents, le volume de lignes traitées, et le taux de rejet à chaque étape. Un tableau de bord de supervision qui affiche ces métriques en un coup d’œil vaut largement mieux que des journaux techniques que seul un ingénieur sait interpréter.
Les alertes automatiques complètent ce dispositif : un seuil de durée dépassé, un volume anormalement bas, un taux d’erreur qui grimpe soudainement doivent déclencher une notification avant que le problème n’atteigne les utilisateurs finaux du reporting. C’est souvent là que la différence se joue entre une équipe qui découvre un problème de données un vendredi soir par un utilisateur mécontent, et une équipe qui le corrige avant même que le rapport ne soit consulté.
Perspective Biworks : ancrer l’ETL dans vos projets Power BI et Fabric
Certaines organisations voient trop de projets Power BI échouer non par manque d’outil, mais par manque de rigueur en amont sur l’ETL. Une approche typique commence par un audit des sources, se poursuit par un prototype de pipeline testé sur données réelles, puis une intégration complète vers Fabric ou Power BI, accompagnée d’une formation pour rendre les équipes autonomes. Un accompagnement managé prend tout son sens dès que la volumétrie ou la réglementation complique la donne.
— François
Structurer vos flux ETL avec un accompagnement expert
Construire un pipeline ETL solide demande du temps, des compétences pointues en modélisation de données, et une bonne dose d’itération avant d’atteindre la fiabilité recherchée. Des acteurs spécialisés accompagnent les entreprises, cabinets comptables et directions financières dans cette démarche, du premier audit d’architecture jusqu’au déploiement complet vers Power BI ou Microsoft Fabric.
Que vous ayez besoin d’un audit technique, d’un prototype rapide pour valider une architecture, ou d’un accompagnement complet sur une montée en charge, notre équipe de consulting en Business Intelligence intervient à chaque étape du projet. Pour les équipes qui souhaitent internaliser ces compétences plutôt que dépendre en permanence d’un prestataire externe, notre organisme de formation certifié Qualiopi prépare aux certifications Power BI, dont le PL 300, avec des sessions éligibles au CPF. Contactez un prestataire spécialisé pour cadrer un audit de vos flux de données actuels et évaluer la meilleure trajectoire vers un pipeline fiable et exploitable.
Sources
- Qu’est-ce que l’ETL ? | Oracle France
- Qu’est‑ce que ETL ? | IBM
- Azure architecture guide — ETL (Microsoft Learn)
- Extraire, transformer, charger : ce qu’est l’ETL et comment il fonctionne (Fivetran)
Questions fréquentes
Qu’est-ce qu’un ETL en informatique ?
Un ETL est un processus qui extrait des données de sources multiples, les transforme selon des règles métier (nettoyage, agrégation, validation), puis les charge dans un entrepôt ou un lac de données pour l’analyse.
Quelles normes encadrent les processus ETL ?
Il n’existe pas de norme technique universelle unique pour l’ETL ; les pratiques s’appuient plutôt sur des principes de gouvernance des données, de traçabilité et de sécurité propres à chaque secteur régulé (banque, santé, comptabilité).
Quels sont les critères pour bien choisir un outil ETL ?
Les critères clés sont la richesse des connecteurs disponibles, la scalabilité face à la montée des volumes, l’observabilité en production, la capacité d’orchestration native et le coût total incluant la maintenance, au delà du prix de licence affiché.
Qu’est-ce que l’ELT et en quoi diffère-t-il de l’ETL ?
L’ELT charge d’abord les données brutes dans l’entrepôt cible, puis les transforme directement là où elles résident, en s’appuyant sur la puissance de calcul du cloud, contrairement à l’ETL qui transforme avant de charger.